Bạn đang sử dụng trình duyệt lỗi thời. Trình duyệt này có thể không hiển thị đúng trang web này hoặc các trang web khác. Bạn nên nâng cấp hoặc sử dụng trình duyệt thay thế.
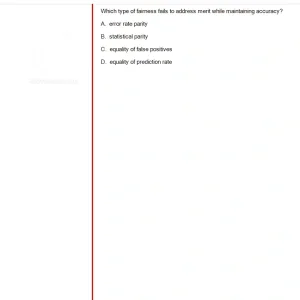
Trong Đạo đức AI và Học máy, các định nghĩa về sự công bằng (fairness) thường mâu thuẫn với nhau. Thuật ngữ cốt lõi ở đây là "năng lực/sự xứng đáng" (merit) — tức là một cá nhân thực sự có đủ điều kiện khách quan để nhận được kết quả tốt (ví dụ: đủ năng lực để được nhận vào làm việc, đủ khả năng trả nợ để được vay vốn).
Vì sao B đúng? "Statistical parity" (Bình đẳng thống kê - hay còn gọi là Demographic Parity) đòi hỏi thuật toán phải đưa ra tỷ lệ quyết định có lợi (positive outcomes) bằng nhau cho tất cả các nhóm nhân khẩu học, bất kể năng lực thực tế của họ là gì. Ví dụ: Nếu áp dụng bình đẳng thống kê, công ty phải tuyển đúng 50% nam và 50% nữ, ngay cả khi tỷ lệ hồ sơ đạt chuẩn (merit) thực tế của hai nhóm này không bằng nhau. Do đó, nhược điểm lớn nhất của "Statistical Parity" là nó hoàn toàn bỏ qua yếu tố năng lực (fails to address merit) và có thể làm giảm độ chính xác chung của mô hình vì buộc phải chọn những người không đủ tiêu chuẩn chỉ để đạt được chỉ tiêu tỷ lệ.
Vì sao A, C và D sai? Các khái niệm như "Error rate parity", "Equality of false positives", hay các tiêu chí công bằng dựa trên tỷ lệ lỗi (như Equality of Opportunity) thường tính toán sai số dựa trên nhãn thực tế (ground truth). Tức là, chúng xem xét tỷ lệ lỗi trên những người thực sự xứng đáng. Do đó, các phương pháp này có tính đến "merit" (năng lực thực tế) của dữ liệu đầu vào thay vì cào bằng tỷ lệ mù quáng như Statistical Parity.